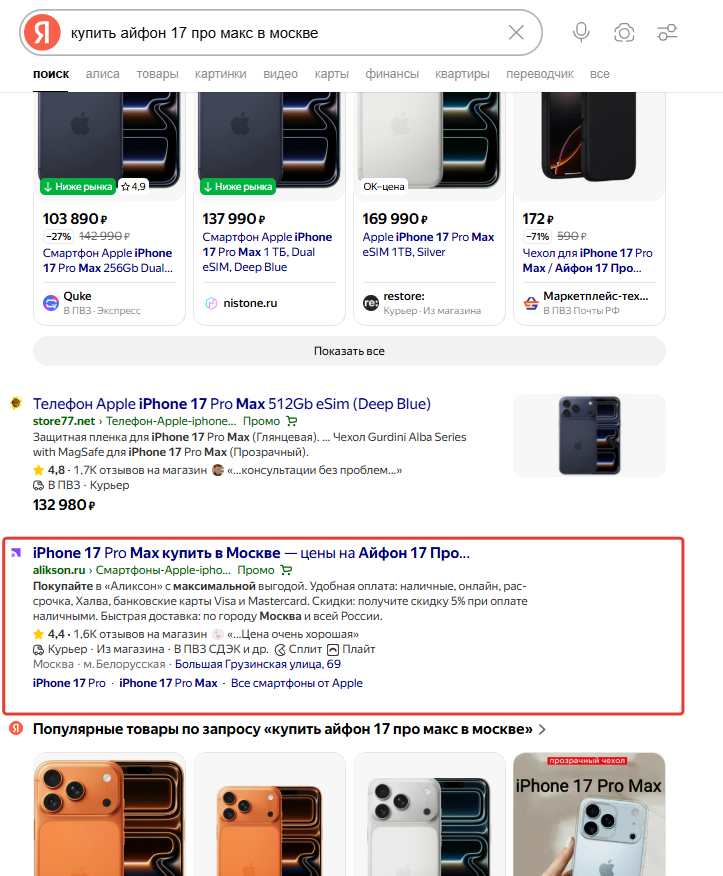
SERP со всеми текстовыми блоками Яндекс Директ:
Search Engine Results Page (SERP) — результаты, которые поисковая система показывает на первой странице поисковой выдачи в ответ на каждый запрос. Получая слепок выдачи, разбирая его блоки, мы предоставляем возможность пользователям видеть метрики и показатели по количеству, позициям, составу блоков Яндекс.Директ.
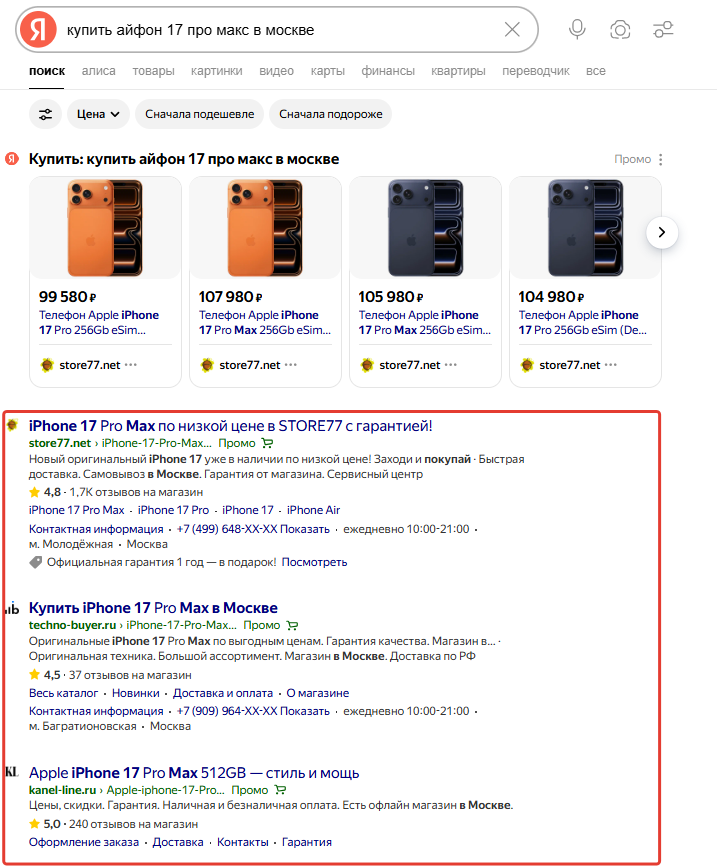
Разбирая слепок результатов поисковой выдачи, мы получаем данные о текстово-графических объявлениях (текстовые блоки) Яндекс.Директ, в том числе:
- позиции показа объявлений
- URL страниц, на которые ведут объявления
- UTM-метки, с разобранными обязательными параметрами (utm_source, utm_medium и т.д.)
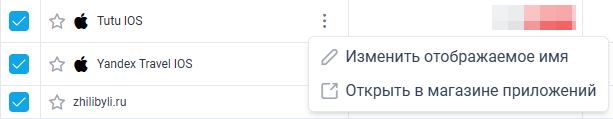
- ссылки на скачивание приложение из магазинов мобильных приложений google play, app store* и т.д.
* так как ссылки на мобильные приложения из магазина app store не имеют отображаемого читаемого идентификатора владельца приложения, в платформе Dataforce ADS предусмотрено наличие пользовательского справочника, с помощью которого можно связать id мобильного приложения, получаемого из ссылки на магазин app store с произвольным пользовательским названием
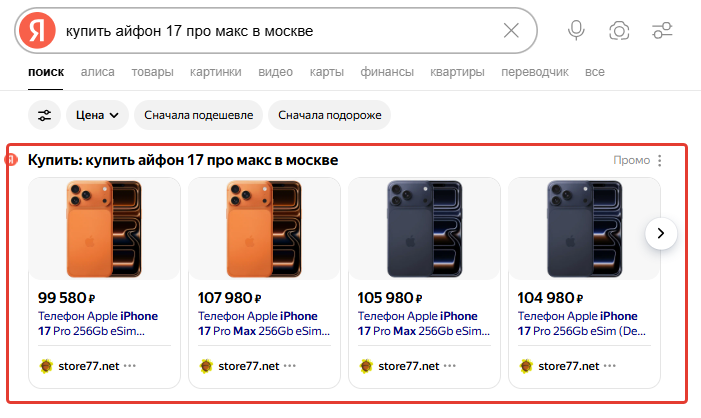
SERP Extra
Помимо текстово-графических объявлений, мы получаем, обрабатываем и храним данные о товарах, отображаемых в блоке «Товарная галерея Яндекс Директ». В том числе:
- позицию показа товара
- отображаемое название товара
- имя вендора
- цена товара
- отображаемое кол-во товаров (всего и в видимой области)
В связи со спецификой HTML-верстки недоступно получение конечных URL-адресов, которые ведут на страницы товаров из блока Товарная галерея Яндекс.Директ. Однако, для идентификации данных о продавце товара, мы получаем, обрабатываем и предоставляем информацию, агрегированную по отображаемому имени вендора (продавца). Это делает аналитику по данному блоку детализированной.
Динамические места в поиске
Динамические места в поиске — это новый вид рекламного размещения Яндекс.Директ, которое работает только в совокупности с SEO-оптимизацией продвигаемых страниц. Специфика данного типа рекламного объявления в том, что в результатах поисковой выдачи оно не отличается от обычного текстово-графического объявления Яндекс.Директ. Что делает его идентификацию и анализ затруднительным. Однако, в платформе Dataforce ADS есть функционал, позволяющий идентифицировать данные объявления через HTML-разметку, сохранять информацию по атрибутам таких объявлений и давать детальную аналитику. Данные о динамических местах показа на поиске, в том числе:
- позиция показа объявлений
- URL-страницы, на которую ведет объявление
- UTM-метка, с разобранными обязательными параметрами (utm_source, utm_medium и т.д.)
- ссылка на скачивание приложение из магазинов приложений google play, app store и т.д.
Данные по UTM-меткам
Кроме ссылок из объявлений Яндекс.Директ, платформа Dataforce ADS собирает, агрегирует и представляет в удобном формате для аналитики информацию о составе UTM-меток. Данные собираются атрибутивно в соответствии с общими правилами составления меток, что позволяет анализировать метки конкурентов, получая представление о структуре рекламных кампаний, в том числе:
- utm_source — данные об источнике трафика
- utm_medium — данные о канале трафика
- utm_campaign — данные о кампании Яндекс.Директ
- utm_content — данные о группе объявлений и об объявлении Яндекс.Директ
- utm_term — данные об условии показа объявления
Спрос
Помимо данных SERP, платформа пользуется ёмкостью спроса семантического ядра, по которому проводится анализ состава рекламной части поисковой выдачи Яндекс. Для этого в платформе предусмотрен сбор частотности из Яндекс.Вордстат поисковых запросов, по которым идут показы блоков рекламы Яндекс.Директ. Доступно несколько типов частотности:
- широкое соответствие — WS
- точное соответствие — «WS»
Конкуренты
Преимущество данных Dataforce ADS в том, что данные собираются из слепков реальной поисковой выдачи, что дает возможность получить детальную информацию о конкурентах, представленных в рекламном поиске Яндекса. Данные собираются по всем участникам поисковой выдачи, а значит можно анализировать:
- плотность присутствия конкурентов в рекламной выдаче
- покрытие семантики присутствием конкурентов
- ценовой диапазон товарных позиций конкурентов, представленных в Товарных блоках
Подробнее о расчётах конкурентов можно узнать в статье по модулю SOI Конкуренты.
Полнота и качество данных
Так как источниками данных для большинства экранов Dataforce ADS является реальная, «живая» поисковая выдача Яндекс, что исключает возможность пересборов данных «в прошлое», полноте и качеству данных уделяется особое внимание.
Полнота данных
Для обеспечения полноты данных, предусмотрены внутренние инструменты мониторинга:
- ежедневный контроль/мониторинг полноты сбора слепков поисковой выдачи по пользовательской семантике
- ежедневный контроль/мониторинг качества парсинга
- аналитика актуальности всех блоков выдачи и доработка алгоритмов разбора выдачи
Точность данных
Для обеспечения точности данных, например, для обеспечения объективности состава поисковой выдачи с поправкой на время суток, организованы сборы в течение дня по расписанию:
- несколько сборов в течение дня
- автоматическая проверка и пересбор данных
- оперативная доработка разбора изменения HTML-верстки выдачи
Так как рекламная активность по времени суток распределяется неравномерно, мы предусмотрели гибкую настройку в наиболее пиковые временные отрезки в течение дня. Это позволяет анализировать свою видимость и видимость конкурентов во временные слоты с максимальным потенциальным трафиком.
Сборы распределяются с 10:00 до 20:00, на них приходится 70+% от всей потенциальной аудитории. Мы уделяем отдельное внимание максимальной стабилизации данных за счет нескольких сборов в день и усреднение результатов.
Средние значения периодичности сборов обычно варьируются в зависимости от типа семантического ядра, загруженного в проект для отслеживания:
- Для аналитики защиты брендового трафика собирается от 3 до 5 раз в сутки.
- Для аналитики коммерческого трафика стандартные тарифы предполагаются сбора от 1 до 2 раз в сутки.
Скорость обработки данных
Мы понимаем, что крупные проекты могут содержать десятки тысяч поисковых запросов, и отображение метрик и показателей по такому объему сильно зависит от скорости обработки данных, поэтому предусмотрели подключение выделенных серверов для ускорения обработки данных крупных проектов.
Другими словами: мы постоянно следим за полнотой и качеством собранных данных, используем для этого собственную многоуровневую систему мониторинга, что делает данные полными и надежными для проведения аналитической работы.